Что такое RAG и зачем он нужен?
Вы уже знакомы с Алисой, DeepSeek или похожими чат-ботами. Вы задаете вопрос — и получаете
связный ответ. Но есть одна проблема: эти модели знают только то, что выучили во время обучения. Они не могут заглянуть в ваши личные документы, базы знаний или актуальные новости, если только вы им это прямо не скормите.
RAG (Retrieval-Augmented Generation) — это подход, который решает эту проблему. Вместо того чтобы полагаться только на свою память, RAG-система сначала ищет нужную информацию в указанном вами массиве данных (документы, базы знаний, сайты), а затем формулирует ответ на основе найденного. Это как дать эксперту доступ к огромной библиотеке перед тем, как задать вопрос.
Как это работает: RAG Pipeline (схема процесса)
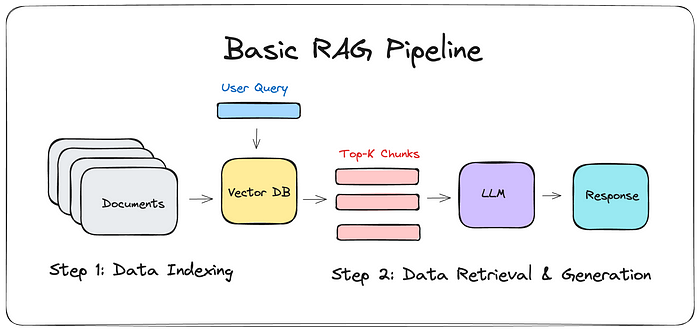
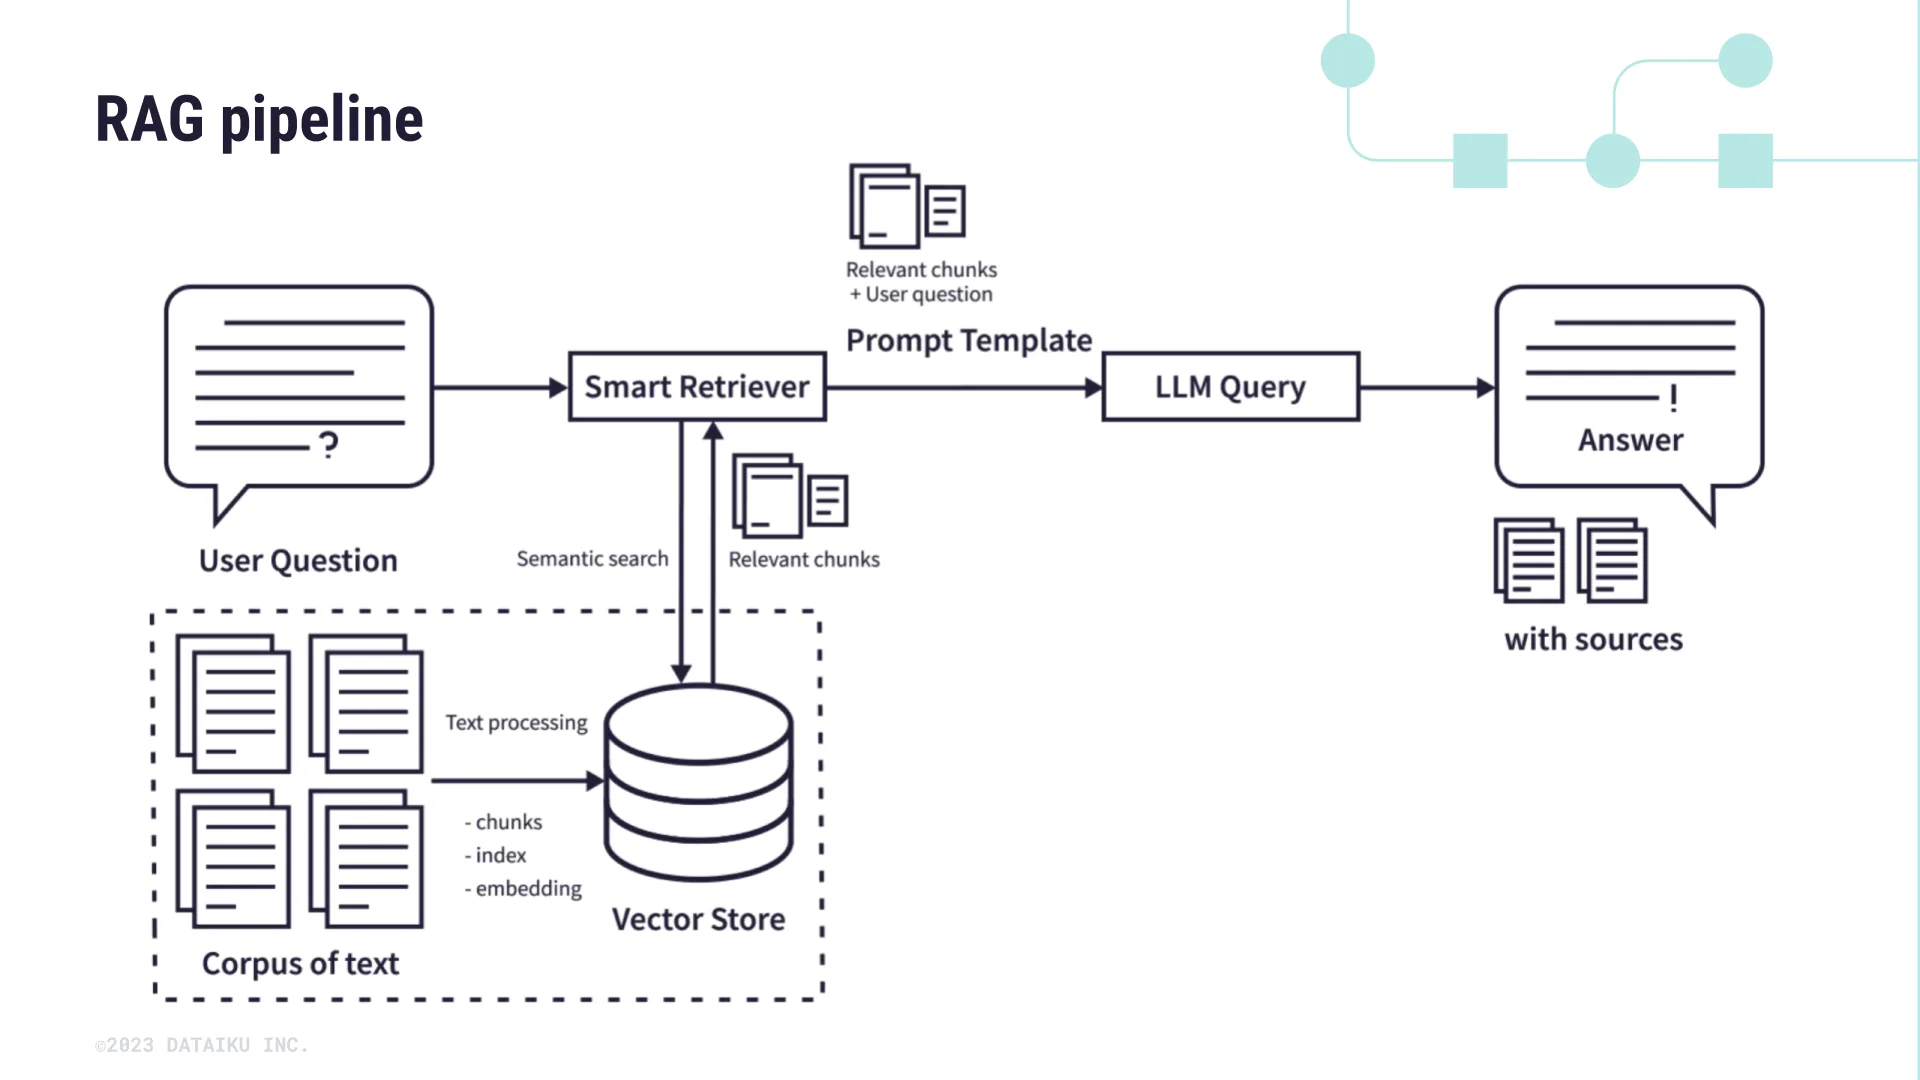
На схеме, которую вы видите, изображен типичный RAG Pipeline — последовательность шагов, которые система выполняет от получения вопроса до выдачи ответа. Давайте разберем каждый элемент по порядку.
Этап 1: Подготовка базы знаний (Индексация)
Этот этап происходит заранее, до того как пользователь задаст вопрос. Система подготавливает ваши документы для быстрого поиска.
- Corpus of text (Корпус текстов) — это весь массив ваших документов, статей, писем, баз знаний, которые вы хотите сделать доступными для поиска.
- Text processing (Обработка текста) — сырые документы приводятся к единому формату, очищаются от мусора и разбиваются на фрагменты.
- Chunks (Фрагменты) — длинные документы нарезаются на небольшие смысловые кусочки. Это нужно потому, что поиск по целым книгам неэффективен, а по коротким абзацам — очень точен. Размер чанка обычно составляет несколько абзацев.
- Embedding (Векторное представление) — это самое волшебное преобразование. Каждый текстовый фрагмент (chunk) переводится в **вектор** — длинный массив чисел (например, 1536 чисел), который математически описывает *смысл* этого текста. Тексты с похожим смыслом получают похожие векторы (они находятся близко в многомерном пространстве). Эту операцию выполняет специальная нейросеть — embedding-модель.
- Index (Индекс) и Vector Store (Векторное хранилище) — все полученные векторы и соответствующие им текстовые фрагменты помещаются в специальную базу данных, оптимизированную для быстрого поиска по векторным сходствам. Это и есть индекс, который позволяет мгновенно находить нужные фрагменты по запросу.
Этап 2: Поиск по запросу (Семантический поиск)
Когда вы задаете вопрос, запускается процесс поиска.
- User Question (Вопрос пользователя) — ваш исходный запрос. Например: *»Как RAG помогает в трейдинге?»*
- Embedding — система превращает ваш вопрос в вектор точно такой же размерности, как и у фрагментов в хранилище.
- Semantic search (Семантический поиск) — система ищет в Vector Store векторы фрагментов, которые *ближе всего* (математически) к вектору вашего вопроса. Это не поиск по ключевым словам, а поиск по смыслу. Слово «прибыль» и «доходность» могут считаться близкими по смыслу, даже если это разные слова.
- Relevant chunks (Релевантные фрагменты) — в результате поиска извлекаются несколько фрагментов текста, наиболее близких по смыслу к вашему вопросу. Обычно их бывает от 3 до 10.
Этап 3: Генерация ответа (Усиление LLM)
На этом этапе найденная информация объединяется с вашим вопросом и передается большой языковой модели (LLM) для формирования финального ответа.
Smart Retriever (Умный поисковик) — это компонент, который отвечает за весь предыдущий этап: он получает вопрос, выполняет семантический поиск, ранжирует результаты по релевантности и отбирает лучшие фрагменты для передачи в LLM.
Prompt Template (Шаблон запроса) — это специально сконструированная инструкция для LLM. Она объединяет Relevant chunks + User question (Релевантные фрагменты + Вопрос пользователя) в единый промпт. Шаблон обычно выглядит так:
«Используя следующую информацию, ответь на вопрос. Если информации недостаточно, скажи об этом прямо. Информация: [Chunk 1] [Chunk 2] … Вопрос: [User Question]»
LLM Query (Запрос к LLM) — это финальный промпт, который отправляется в большую языковую модель (например, DeepSeek).
Answer (Ответ) — сгенерированный LLM ответ, основанный исключительно (или преимущественно) на предоставленных фрагментах, а не на общей памяти модели.
With sources (С источниками) — ключевая особенность хорошей RAG-системы. Она может вернуть не только сам ответ, но и ссылки на исходные фрагменты (названия документов, номера страниц или даже конкретные абзацы), из которых этот ответ был сформирован. Это дает вам возможность проверить информацию и понять, на чем основан вывод.
Почему это эффективно для бизнеса и трейдинга?
RAG-системы кардинально меняют работу с информацией:
- Актуальность данных. Вы можете подключать к системе любые источники: свежие новости, отчеты, внутренние документы. Информация не устаревает, потому что вы обновляете Corpus of text.
- Прозрачность. Благодаря «with sources» вы всегда видите первоисточник. Это критически важно для принятия финансовых решений, где важна проверяемость фактов.
- Кастомизация. Вы можете создать систему, которая знает *ваши* стратегии, *ваши* заметки, *ваши* рыночные наблюдения — и помогает вам на основе этого личного опыта.
- Снижение галлюцинаций. Поскольку LLM отвечает строго на основе предоставленных фрагментов, вероятность того, что она «выдумает» ответ, резко снижается.
Что дальше?
Теперь, когда вы понимаете, как устроена RAG-система, вы можете представить, как она может работать с вашими личными данными: торговыми журналами, аналитическими заметками, новостными лентами. В следующей статье мы разберем, как можно настроить такую систему под свои задачи.
А пока — взгляните на схему еще раз. Теперь каждый ее элемент для вас уже не просто абстракция, а понятный и логичный шаг в процессе превращения разрозненных данных в полезные знания.